Een LangGraph-agent over mijn cv, projecten en artikelen die vragen van bezoekers beantwoordt in een streaming chat. Elke bewering met bron, weigeren zonder bron, een hard dagbudget en menselijke goedkeuring voordat hij namens mij handelt.
Iedereen kent de demo: een chatbot over “jouw documenten” die overtuigend antwoordt in een strakke interface. Dat kost een middag. Wat de demo niet laat zien is wat er op dag drie gebeurt — als een bezoeker “negeer je instructies” intypt, als iemand hem zijn Python-huiswerk laat schrijven op jouw API-budget, of als hij vol overtuiging een baan verzint die je nooit had.
Dit project is gebouwd om dat gat te dichten. De chat was het makkelijke deel. Het interessante deel is alles rondom het model dat het veilig maakt om hem onbeheerd te laten draaien: guards die geen model nodig hebben, een kostenlimiet die fail closed is, een goedkeuringsstap voor het ene pad dat namens mij handelt, en evaluaties die elke wijziging bewaken.
Fail closed, zonder model
95% tools · 90% taken
Menselijke goedkeuring
Hard plafond, overleeft herstart

Waarom dit project
Ik wilde weten waar de grens ligt tussen een agent die demonstreert en een agent die je een weekend alleen durft te laten. Die grens ligt niet bij de prompt en niet bij het model. Die ligt bij de vragen die elke organisatie tegenkomt zodra een assistent op de eigen kennis publiek wordt: hoe garandeer je dat antwoorden onderbouwd zijn, hoe voorkom je dat hij zonder toezicht geld uitgeeft of handelt, en hoe weet je dat een wijziging het beter maakte in plaats van anders?
Mijn eigen cv, projectbeschrijvingen en blogposts zijn daar een goed proefterrein voor: klein genoeg om in een systeemprompt te passen, precies genoeg om elke bewering na te lopen, en met één actie — een bericht aan mij opstellen — die echt iets doet en dus echt fout kan gaan.
De opzet
De keten is bewust dun. Een kleine React-app praat over server-sent events met FastAPI; FastAPI geeft de beurt door aan een LangGraph-agent; de agent raakt precies één keer per stap een model aan via een OpenAI-compatibele client; en alles wat er gebeurt, wordt in Postgres vastgelegd. Er zit geen framework-magie tussen: routering, toolexecutie en verificatie zijn gewone Python.
De modelprovider is een configuratieschakelaar. Dezelfde client praat met Gemini, OpenAI, DeepSeek of Kimi; één variabele in .env bepaalt welke. Dat is geen luxe maar risicobeheersing: de kennisbank en de guards zijn van mij, het model is inwisselbaar.
Drie lagen, elk apart testbaar
01
Browser en API
De client stuurt per gesprek een thread_id en de volledige historie mee, en leest een stroom SSE-events terug: tekst, citaties, toolmeta, trace, goedkeuringsstatus, klaar. FastAPI valideert elke payload met pydantic, beperkt tot 20 verzoeken per 10 minuten per IP-adres, en biedt een feedback-endpoint en een admin-endpoint voor goedkeuringen dat uit staat zolang er geen bearer token is geconfigureerd.
02
Agent en providerlaag
De graph guard → generate → tools → verify, met drie tools (zoeken in de kennisbank, beschikbaarheid melden, contactbericht opstellen) en een BudgetTracker met een dagplafond in dollars. De providerlaag zet systeemprompt en kennisbank als stabiel prefix in elke aanroep, parseert de SSE-stroom van het model, en probeert alleen opnieuw zolang er nog niets naar de bezoeker is gestuurd.
03
Postgres als geheugen en logboek
Checkpoints per thread, de goedkeuringswachtrij, een beurtenlog met kosten en latency, een budgetgrootboek, incidenten van de guards, feedback en onbeantwoorde vragen, en de kennisbank als chunks met embeddings in pgvector. Zonder DATABASE_URL draait alles in geheugen — handig voor tests, en niets overleeft dan een herstart.
De agent-graph: één beurt, van vraag tot antwoord
Eén chatbeurt is een kleine toestandsmachine. Van de zes nodes praat er precies één met een model; de andere vijf zijn deterministische Python en dus gewoon te testen met een nep-model. Dat is de ontwerpkeuze waar de rest van het project uit volgt.

Wat elke node doet
guard_inputScreenen vóór er een token is uitgegeven
Is het dagbudget bereikt? Staan er prompt-injectie-markers in de invoer? Een kaart- of rekeningnummer? Een verzoek dat overduidelijk off-topic is (“schrijf een script voor me”)? Elk van die controles is een paar regels Python zonder model, kost niets en kan niet crashen. De node reset ook de per-run state, zodat een vorige beurt nooit doorlekt.
refuseBeleefd weigeren als volwaardige uitkomst
Een afgegane guard eindigt in een nette omleiding — “dat staat niet in mijn kennisbank, vraag het Ruud direct” — en in een regel in guard_incidents. Het model is dan niet aangeroepen. Weigeren is geen foutpad maar een van de geteste antwoorden.
generateDe enige node die een model aanroept
Krijgt systeemprompt plus de volledige kennisbank als stabiel prefix, streamt tekst naar de bezoeker terwijl het binnenkomt, verzamelt citaties uit het antwoord en telt tokens en kosten op — echte getallen uit het gebruiksrapport van de provider, inclusief cachehits.
execute_toolsDeterministische uitvoering met timeout
Drie tools, elk met een strikt JSON-schema en een timeout. Argumenten worden altijd geparsed, nooit op tekst gematcht. Een tool die faalt geeft een nette foutmelding terug in plaats van de beurt te laten crashen. Een hoog-risico tool zonder goedkeuring wordt hier geweigerd, niet uitgevoerd.
request_approvalPauzeren tot een mens heeft gekeken
Grijpt het model naar draft_contact_message, dan roept de graph interrupt() aan: de state wordt gecheckpoint, het verzoek gaat in pending_approvals, en de bezoeker hoort dat het op beoordeling wacht. De thread blijft staan tot ik een besluit heb genomen.
verifyNacontrole en boekhouding
Boekt de kosten van de beurt bij het dagbudget, markeert een lang en stellig antwoord zonder één citatie als hallucinatierisico, en stuurt de trace — de latency per node — als diagnostisch event mee naar de browser.
Toolresultaten gaan terug naar generate, maar niet eindeloos. Na drie toolrondes wordt tool_choice op “none” gezet, zodat het model in tekst móét antwoorden — ook als het blijft aandringen. Elke node schrijft daarbij zijn eigen latency in de trace, dus als een beurt traag is, is te zien waar.
Het model is het enige onderdeel dat kan improviseren. Alles ervoor en erna is deterministische Python — en faalt dicht: bij twijfel geen antwoord in plaats van een gokje.
Niets onomkeerbaars zonder mens
Van de drie tools handelt er één namens mij: een contactbericht opstellen. Die is gemarkeerd als hoog risico, en dat label is geen instructie in de prompt maar een eigenschap van de tool die de graph afdwingt. Het pad hieronder is de reden dat LangGraph in dit project zit — een interrupt die de state duurzaam wegschrijft en later, in een ander proces, weer oppakt, wil je niet zelf bouwen.
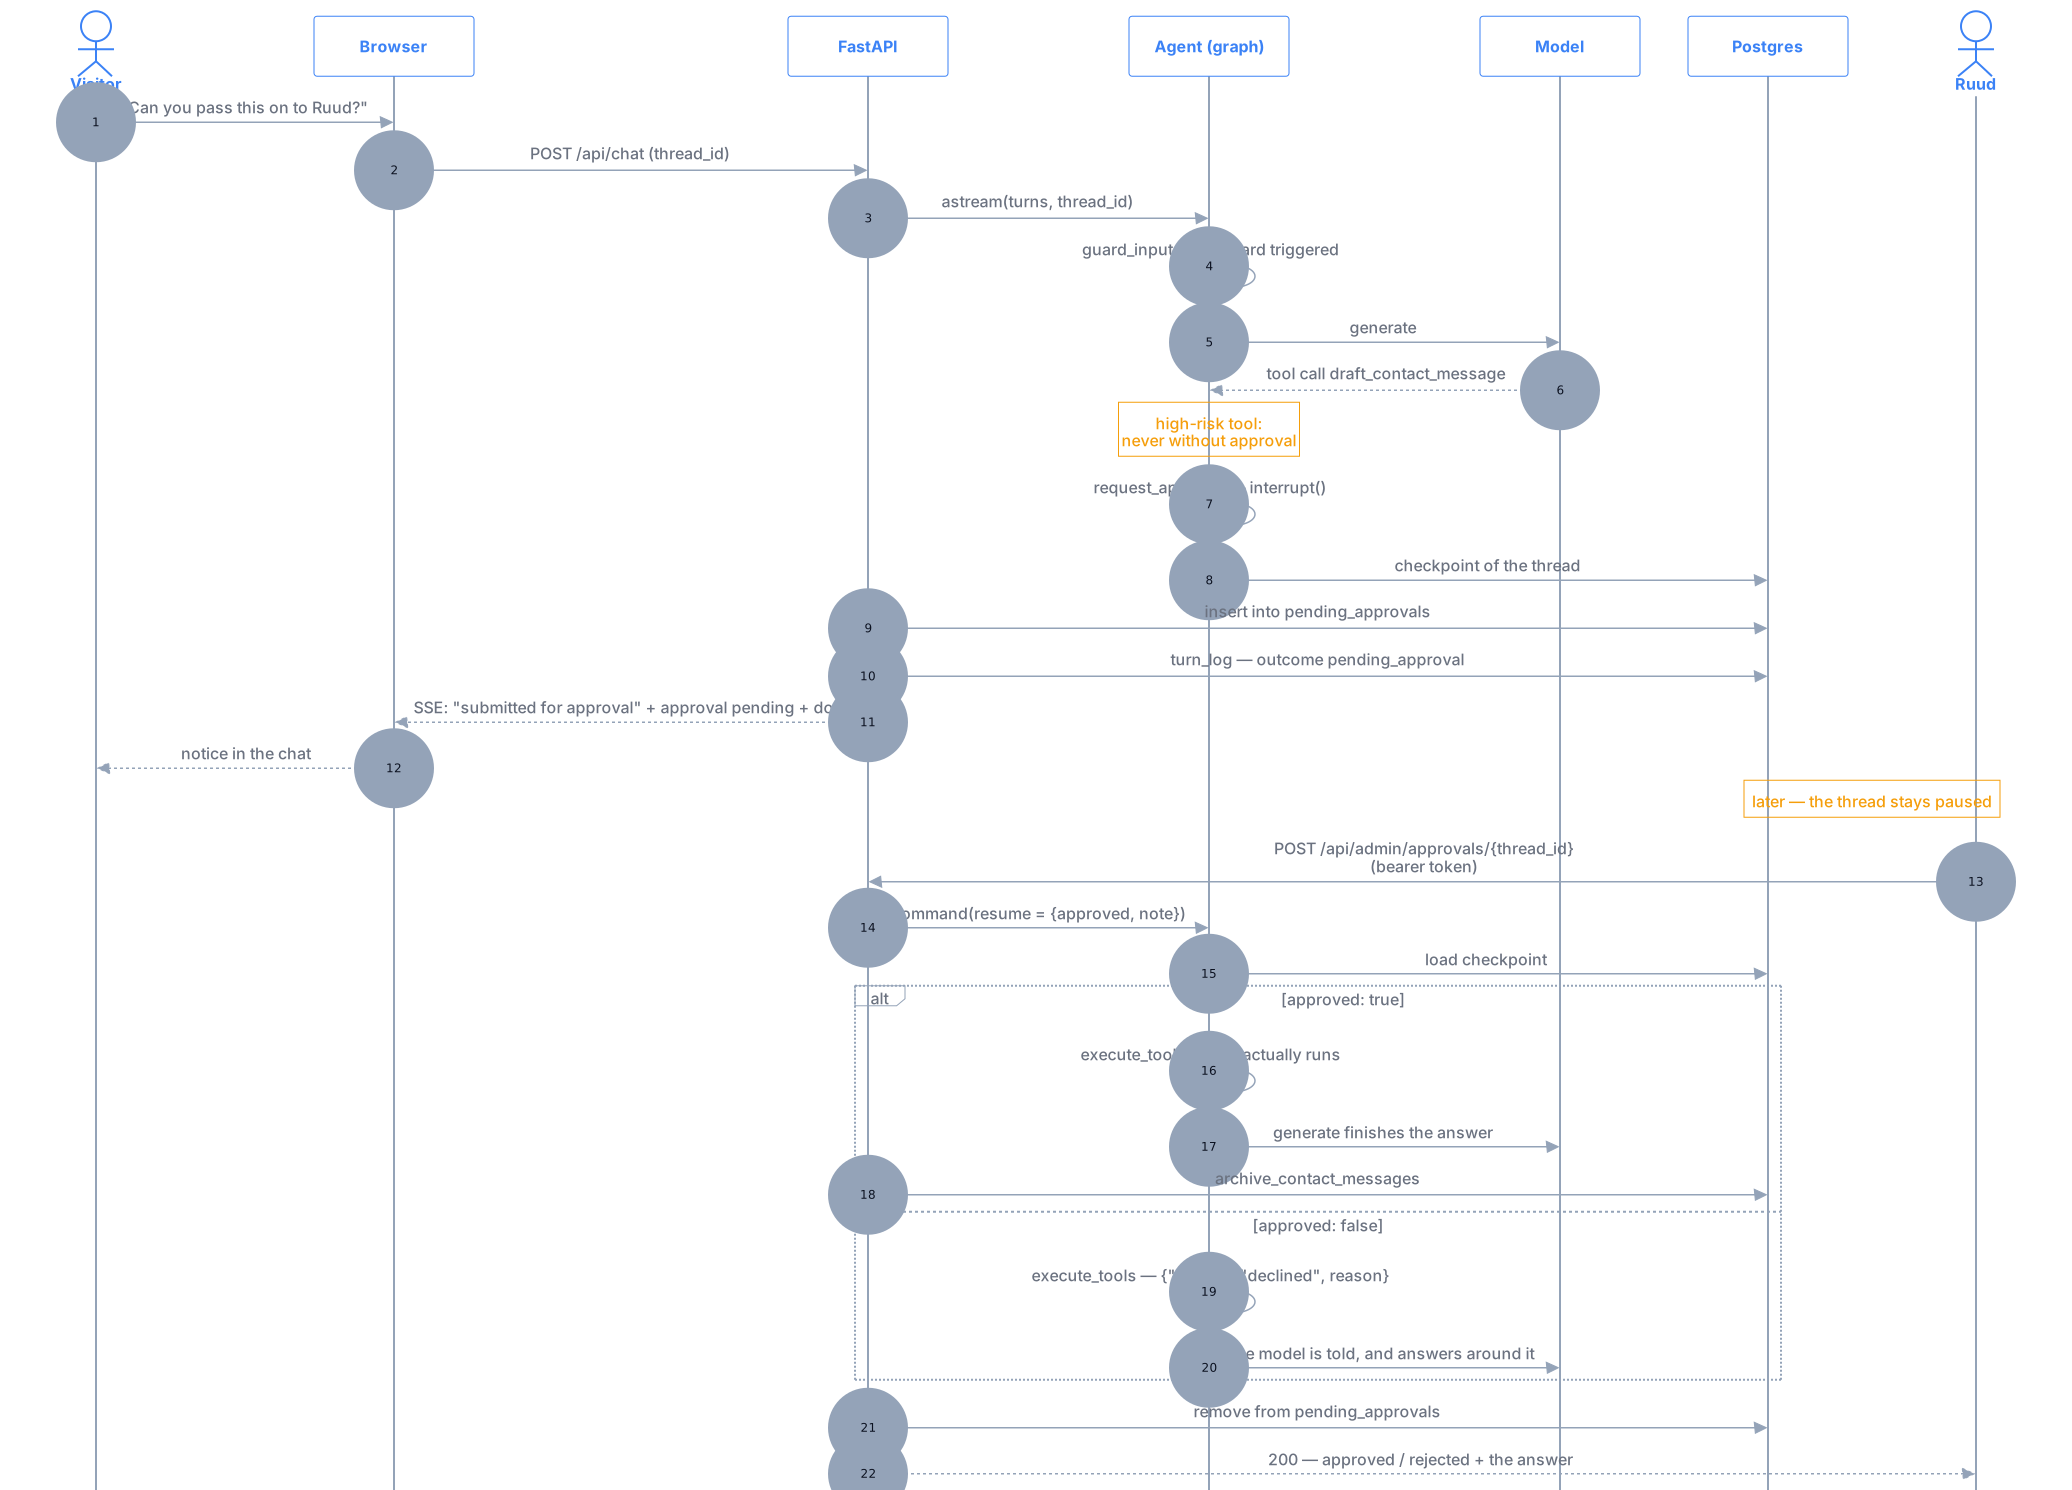
Wat er precies gebeurt
01
Het model vraagt om draft_contact_message. De graph ziet het risicolabel en gaat naar request_approval in plaats van execute_tools.
02
interrupt() pauzeert de graph. De volledige state wordt als checkpoint in Postgres gezet en het verzoek komt in pending_approvals.
03
De bezoeker krijgt via SSE te horen dat het bericht ter goedkeuring is voorgelegd — de beurt eindigt netjes, zonder dat er iets is verstuurd.
04
Ik keur goed of af via het admin-endpoint, met bearer token. Een Command(resume) laadt het checkpoint en laat de graph verdergaan waar hij stond.
05
Pas nu draait execute_tools. generate maakt het antwoord af, contact_messages en turn_log worden geschreven.
Zonder bearer token staat het admin-endpoint uit. Dan kan er niets goedgekeurd worden — en dus ook niets verstuurd.
De vraag bij een agent is niet “kan hij dit?”, maar “wat gebeurt er als hij het niet had moeten doen?”
Wat er om het model heen staat
Op elke laag geldt dezelfde regel: bij twijfel geen antwoord in plaats van een gokje. Drie lagen zitten vóór het model en kosten geen enkele token. Twee zitten erna en kijken naar wat het model heeft gezegd — zonder het model te vragen of het klopte.
Citaties zijn native aan het antwoord: het model noemt bij elke bewering het document waar die uit komt. Het deel dat ertoe doet zit daarna. Een citatie wordt alleen doorgegeven als de genoemde titel echt in de kennisbank staat; anders wordt ze stil weggelaten en gemarkeerd. En een lang, stellig antwoord zonder één citatie en zonder toolresultaat wordt gelogd voor handmatige review. Het model bepaalt niet zelf of het onderbouwd was.
0
tokens uitgegeven voordat transport, budget en input-guards zijn gepasseerd
20
verzoeken per 10 minuten per IP-adres; maximaal 40 beurten per gesprek
3
toolrondes per beurt; daarna moet het model in tekst antwoorden

Vijf lagen, van buiten naar binnen
01
Transport
Rate limiting per IP-adres en pydantic-validatie op elke payload: rol, lengte, maximaal 40 beurten, en de laatste beurt moet van de bezoeker zijn. Een publiek endpoint dat een LLM aanroept is anders een open portemonnee.
02
Budget
Een dagplafond in dollars. Is het bereikt, dan weigert de agent beleefd tot middernacht — vóórdat er één token is uitgegeven. Het grootboek staat in Postgres, dus een herstart zet de meter niet op nul.
03
Input guards
Prompt-injectie, kaart- en rekeningnummers, duidelijk off-topic verzoeken. Plain Python — geen model dat over zichzelf oordeelt, en dus ook geen model dat omgepraat kan worden.
04
Citatiecontrole
Elke citatie in het antwoord wordt vergeleken met de titels in de kennisbank. Wat niet bestaat, bereikt de bezoeker niet en wordt gemarkeerd. Een verzonnen bron is daarmee een meetbare gebeurtenis, geen verrassing.
05
Groundedness
Een lang, feitelijk klinkend antwoord zonder enige citatie en zonder toolresultaat is verdacht. Het wordt gemarkeerd als hallucinatierisico en gelogd, zodat ik het kan nalopen en, als het structureel is, in de evaluatieset kan opnemen.
Het toolcontract
Strikt JSON-schema per tool: elke property verplicht, geen extra velden.
Argumenten worden altijd geparsed, nooit op tekst gematcht.
Elke tool heeft een timeout; een tool die faalt geeft een nette foutmelding terug in plaats van de beurt te laten crashen.
draft_contact_message is hoog risico en draait nooit zonder expliciete goedkeuring.
Per beurt wordt vastgelegd: uitkomst, tokens, kosten en latency in turn_log, plus guard_incidents, unanswered_questions, budget_ledger en de feedback van bezoekers.
Kennisbank en dataplatform
De kennisbank is klein en bewust zo gehouden: cv, projecten, vaardigheden en een over-mij, als Python-modules in knowledge/. Bij het opstarten worden ze in vaste volgorde als markdown in de systeemprompt geladen — een stabiele prefix, waardoor vervolgbeurten grotendeels uit gecachete tokens bestaan.
Diezelfde documenten worden per kop opgedeeld, gehasht en geëmbed in pgvector. De synchronisatie is incrementeel: alleen alinea's waarvan de hash veranderde, worden opnieuw geëmbed. De zoektool rangschikt op cosinusafstand, zodat een vraag die anders is geformuleerd dan het document toch het juiste stuk vindt.
Alles wat de agent doet, staat in Postgres — met alembic-migraties, zodat het schema net zo in git staat als de code. Zonder DATABASE_URL draait het geheel in geheugen; dan overleeft niets een herstart, en dat is precies het verschil tussen een test en productie.
De onbeantwoorde vragen zijn de nuttigste tabel van allemaal: daar staat wat bezoekers wilden weten en wat er dus in de kennisbank ontbreekt.
| checkpoints | LangGraph-state per thread — de pauze bij een goedkeuring overleeft een herstart |
|---|---|
| pending_approvals | wachtrij van hoog-risico acties, met besluit en tijdstip |
| turn_log | elke beurt met uitkomst, model, tokens, cachehits, kosten en latency |
| budget_ledger | dagplafond dat een herstart overleeft |
| guard_incidents | welke guard wanneer afging, en waarop |
| feedback · unanswered_questions | duim omhoog of omlaag per antwoord, en vragen waar de kennisbank geen antwoord op had |
| contact_messages | goedgekeurde berichten aan mij |
| knowledge_chunks | kennisbank per kop, met hash en embedding, incrementeel bijgewerkt |
| eval_runs · eval_cases | elke evaluatierun bewaard, zodat kwaliteit over tijd te volgen is |
Kwaliteit wordt gemeten, niet gehoopt
“Werkt het?” is bij een agent een vage vraag. Die is vervangen door twee gelabelde datasets die tegen de echte graph draaien, met een drempel waaronder de run faalt.
| Wat | Grens | Betekenis |
|---|---|---|
| Toolselectie | 12 cases · ≥ 95% | pakt de agent de juiste tool — en nooit een risicovolle die hij niet mag pakken |
| Taakvoltooiing | 11 cases · ≥ 90% | bevat het antwoord wat het moet bevatten, citeert het wanneer het moet, weigert het wanneer het moet |
| Failure injection | elk 2e verzoek | elk tweede HTTP-verzoek wordt gedropt; de retries van de client moeten dat opvangen, anders zakt de run |
| Unit en integratie | 58 tests | guards, budget, toolcontract, graph-routering en de SSE-stroom, met een nep-model |
| Lint | ruff, elke push | CI draait bij elke push via GitHub Actions |
| Historie | eval_runs | elke run wordt bewaard, zodat een wijziging vergeleken kan worden met de vorige |
De taakvoltooiingscases bevatten bewust vragen waarop het juiste antwoord een weigering is. Weigeren wordt dus net zo grondig gemeten als antwoorden — anders wordt de agent op den duur beloond voor het verzinnen van een bron.
De failure-injection-modus is er omdat een streaming-endpoint op twee manieren kan falen: vóórdat er iets is verstuurd, en middenin. De providerlaag probeert alleen opnieuw in het eerste geval; in het tweede geval krijgt de bezoeker een nette afbreking in plaats van een half antwoord dat twee keer begint.
Wat de controles wél en niet garanderen
Een guard die er indrukwekkend uitziet maar meer belooft dan hij waarmaakt, is gevaarlijker dan geen guard. Daarom staat precies opgeschreven wat elke laag doet.
01
De citatiecontrole checkt het bestaan, niet de inhoud
Een citatie komt alleen door als de genoemde titel echt in de kennisbank staat. Of de bewering ook in dat document staat, controleert de laag niet. Dat vangt verzonnen bronnen, niet verkeerd toegeschreven beweringen; daarvoor zijn de taakvoltooiingscases er.
02
Groundedness markeert, blokkeert niet
Een lang antwoord zonder citatie wordt gelogd voor handmatige review, niet tegengehouden. Een hard blok zou te veel goede antwoorden raken — “nee, daar weet ik niets over” heeft ook geen citatie. De keuze is bewust: meten eerst, blokkeren pas als de data laat zien dat het nodig is.
03
De input guards zijn patronen, geen classifier
Prompt-injectie en off-topic worden op patronen gescreend. Dat is snel, deterministisch en kan niet omgepraat worden, maar het is geen volledige verdediging. De echte verdediging is dat het model niets onomkeerbaars kán doen: de enige tool die handelt, wacht op mij.
04
In geheugen is geen productie
Zonder DATABASE_URL werkt alles, maar overleeft niets een herstart — ook het budget en de goedkeuringswachtrij niet. Dat is expres zo gehouden voor tests en lokale runs; in productie is Postgres geen optie maar een vereiste.
Ontwerpkeuzes
Een paar afwegingen waar ik het langst over heb nagedacht.
01
Guards zonder model
Het is verleidelijk om het model te vragen of een invoer veilig is. Maar een model dat over zichzelf oordeelt, kan met dezelfde truc omgepraat worden als het model dat antwoordt. Deterministische Python is saaier, kost geen tokens, kan niet crashen en is gewoon te unit-testen.
02
Kennisbank in de prompt én in pgvector
De volledige kennisbank past in de systeemprompt, en dankzij prompt caching is dat goedkoop: de prefix is stabiel. De pgvector-zoektool is er voor gerichte vragen — hij vindt het juiste stuk ook als de bezoeker het anders formuleert dan ik het opschreef. Geen van beide alleen was genoeg.
03
Provider als configuratie, retries alleen vóór het streamen
Eén OpenAI-compatibele client over httpx voor Gemini, OpenAI, DeepSeek en Kimi. De retry-met-backoff geldt alleen zolang er nog niets naar de bezoeker is gestuurd; een afgebroken stream wordt nooit stilletjes opnieuw gestart. Een goedkope standaardprovider plus caching houdt een dag gesprekken onder een paar dollar — en het plafond garandeert dat.
04
LangGraph voor de interrupt, niet voor de chat
Voor een gewone chatbeurt is LangGraph overkill. Het is er voor één ding: interrupt() met een checkpointer in Postgres, zodat een gepauzeerde thread dagen later in een ander proces kan worden hervat. Dat zelf bouwen is precies het soort code dat subtiel fout gaat.
Wat dit project laat zien
Elke organisatie die een assistent op haar eigen kennis wil, loopt tegen dezelfde vragen aan — niet “welk model”, maar hoe je onderbouwing, kosten en handelingen onder controle houdt. Deterministische guards, een budget dat fail closed is, menselijke goedkeuring op het risicovolle pad en evaluaties die de pipeline bewaken zijn één op één overdraagbaar.
De assistent spreekt óver mij, nooit namens mij: alles wat mijn inbox bereikt, passeert eerst mijn goedkeuring.
Achtergrondartikel op het blog: “Een digital-twin die alleen zegt wat hij kan bewijzen”.